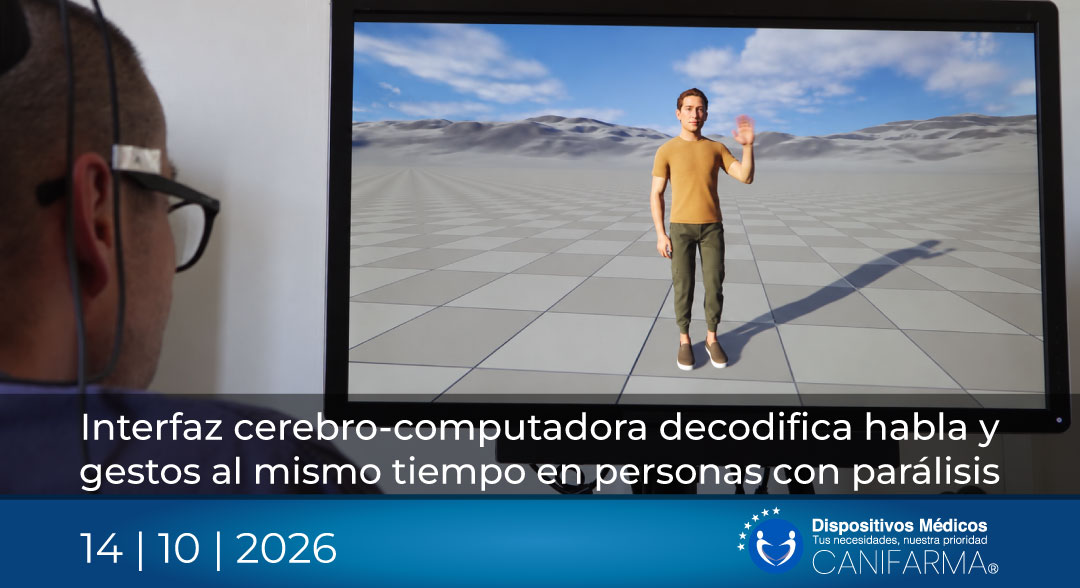
Un equipo de investigadores financiado por los Institutos Nacionales de Salud de Estados Unidos ha desarrollado una interfaz cerebro-computadora capaz de traducir simultáneamente el habla y los gestos corporales, un avance que acerca la tecnología a la forma en que las personas se comunican naturalmente. El trabajo, liderado por el Dr. Edward Chang en la Universidad de California en San Francisco y publicado en Nature Neuroscience, utilizó una pequeña matriz de electrodos implantada quirúrgicamente para registrar señales neuronales de tres participantes con parálisis severa del tracto vocal. Dos de ellos presentaban además parálisis grave de las extremidades, y el tercero, una parálisis moderada.
El sistema traduce esas señales en comandos que controlan un avatar virtual, un modelo digital del propio usuario. Los participantes podían ver cómo su representación digital hablaba y gesticulaba en respuesta a su actividad cerebral. Entre los gestos contemplados se incluyen movimientos tan cotidianos como saludar con la mano o hacer la señal de aprobación con el pulgar. El equipo centró su análisis en la corteza motora, la región del cerebro que gobierna tanto el habla como el movimiento, buscando demostrar que una única matriz de electrodos podía capturar ambos tipos de información sin necesidad de sensores adicionales.
Los resultados confirmaron esa hipótesis. El dispositivo decodificó de forma fiable movimientos aislados de la parte superior del cuerpo, la boca y el rostro de los tres participantes, y además fue capaz de capturar habla y gestos de manera concurrente. Un hallazgo metodológico especialmente relevante fue que entrenar el sistema con datos de intentos simultáneos de habla y gestos, combinados con datos de cada conducta por separado, mejoraba la precisión general de la decodificación. Es decir, la información motora de ambos dominios se refuerza mutuamente cuando el modelo aprende a integrarla.
En las pruebas conversacionales, dos participantes utilizaron su avatar para reproducir acciones concretas y responder a indicaciones de diálogo. La interfaz alcanzó hasta un 82% de precisión al copiar gestos de forma aislada y entre un 65% y un 70% al reproducir gestos y habla de manera simultánea. En contextos conversacionales, la precisión fue de al menos un 85% para los gestos y un 75% para el habla.
El siguiente paso del equipo es abandonar el sistema cableado actual y avanzar hacia una versión totalmente implantable e inalámbrica, un requisito indispensable para que la tecnología pueda usarse en la vida diaria fuera del laboratorio.
Fuentes
 National Institutes of Health (NIH)
Device helps people with paralysis communicate


